单次遍历,带权随机选取问题(一)
在 单次遍历,等概率随机选取问题 中已经剧透了今天的内容,那就是带权随机选取(Weighted Random Sample)问题。
问题描述:有一组数量未知的数据,每个元素有非负权重。要求只遍历一次,随机选取其中的一个元素,任何一个元素被选到的概率与其权重成正比。
设元素总数为 n,当然在遍历结束前 n 是未知的。设第 i(1 <= i <= n)个元素的权重为 wᵢ(> 0),则权重总和为 ,也是在遍历结束时才知道的。根据题目要求,第 i 个元素被选取的概率应该等于 。
虽然加了个权重,但解法依旧非常简单,在 单次遍历,等概率随机选取问题 中的 RandomSelect 函数上稍作修改就得到本问题的解法,依旧是 O(n) 时间,O(1) 辅助空间:
| |
其中 Python 的 random.random() 返回 [0, 1) 之间的随机小数。
看一下是否满足概率要求。如果最终被选取的是第 i(1 <= i <= n)个元素,那必须是遍历到它的时候,恰好被选中,即 rand.random() * totalweight < weight,其概率为:
另外,还要在处理以后的任何一个元素时,第 i 个元素都没有被替换掉,即对于任意的 j(i < j <= n),第 j 个元素都不会被选中,其概率为:
因此,第 i 个元素最终被选取的概率为:
下面这段程序调用 WeightedRandomSelect 对一组具有等差数列权重的元素进行选取。
| |
某次运行结果为:
[1723, 3644, 5405, 7326, 9027, 10903, 12678, 14784, 16345, 18165]而对于这组权重的概率理论值为:
1 : 2 : 3 : 4 : 5 : 6 : 7 : 8 : 9 : 10
= 0.0181818 : 0.0363636 : 0.0545455 : 0.0727273 : 0.0909091 : 0.109091 : 0.127273 : 0.145455 : 0.163636 : 0.181818
可见程序是正确的。
扩展:选取 m 个元素,概率理论值
来看看选取多个元素的问题。当选取多个元素时,可以认为选取过程是逐步进行的,即无放回的多次选取。每一次选取时,任何一个元素被选中的概率都与其权重成正比,但总的权重则又剩余的元素集合决定。
当 m=2 的时候,第 i 个元素被选中可以是两种情况:第一次就被选中;第一次未被选中,第二次被选中。可以得到其概率为这两种情况的概率之和,即:
值得注意的是,即便 wᵢ 和 w 不变,如果其他元素的概率分布不同,最后得到的结果也不同,因此上面这个式子无法把其中的求和化简掉。
从另一方面来看,第 i 个元素被选中的概率等于 1 减去它不被选中的概率。用 表示不被选中的概率,则有:
显然,。
当 m>2 时,其概率表达式将会变得异常复杂,因为跟概率分布有关,所以算式无法化简。未被选中的概率计算式要稍微简单些,大概是这个样子的:
其中,。
对于给定的一组权重,可以用下面这段程序计算出任意 m、i(程序中的 i 是从 0 开始的)对应的概率数值(请无视其 coding style):
| |
可惜算法的复杂度非常高,CalcSampleProbability 需要 O(n^m) 时间来完成一次计算。期待高手改进。
来看一下等权重、等差数列权重和等比数列权重的 n 选 m 概率分布图(图中 i 依旧采用 1 <= i <= n 的取值范围):
查看源代码
{
  "legend": {
    "width": "80%"
  },
  "series": [
    {
      "data": [
        0.1,
        0.1,
        0.1,
        0.1,
        0.1,
        0.1,
        0.1,
        0.1,
        0.1,
        0.1
      ],
      "name": "m=1",
      "type": "line"
    },
    {
      "data": [
        0.2,
        0.2,
        0.2,
        0.2,
        0.2,
        0.2,
        0.2,
        0.2,
        0.2,
        0.2
      ],
      "name": "m=2",
      "type": "line"
    },
    {
      "data": [
        0.3,
        0.3,
        0.3,
        0.3,
        0.3,
        0.3,
        0.3,
        0.3,
        0.3,
        0.3
      ],
      "name": "m=3",
      "type": "line"
    },
    {
      "data": [
        0.4,
        0.4,
        0.4,
        0.4,
        0.4,
        0.4,
        0.4,
        0.4,
        0.4,
        0.4
      ],
      "name": "m=4",
      "type": "line"
    },
    {
      "data": [
        0.5,
        0.5,
        0.5,
        0.5,
        0.5,
        0.5,
        0.5,
        0.5,
        0.5,
        0.5
      ],
      "name": "m=5",
      "type": "line"
    },
    {
      "data": [
        0.6,
        0.6,
        0.6,
        0.6,
        0.6,
        0.6,
        0.6,
        0.6,
        0.6,
        0.6
      ],
      "name": "m=6",
      "type": "line"
    },
    {
      "data": [
        0.7,
        0.7,
        0.7,
        0.7,
        0.7,
        0.7,
        0.7,
        0.7,
        0.7,
        0.7
      ],
      "name": "m=7",
      "type": "line"
    },
    {
      "data": [
        0.8,
        0.8,
        0.8,
        0.8,
        0.8,
        0.8,
        0.8,
        0.8,
        0.8,
        0.8
      ],
      "name": "m=8",
      "type": "line"
    },
    {
      "data": [
        0.9,
        0.9,
        0.9,
        0.9,
        0.9,
        0.9,
        0.9,
        0.9,
        0.9,
        0.9
      ],
      "name": "m=9",
      "type": "line"
    },
    {
      "data": [
        1,
        1,
        1,
        1,
        1,
        1,
        1,
        1,
        1,
        1
      ],
      "name": "m=10",
      "type": "line"
    }
  ],
  "title": {
    "text": "等值权重随机选取"
  },
  "tooltip": {
    "trigger": "axis"
  },
  "xAxis": {
    "boundaryGap": false,
    "data": [
      "i=1",
      "i=2",
      "i=3",
      "i=4",
      "i=5",
      "i=6",
      "i=7",
      "i=8",
      "i=9",
      "i=10"
    ],
    "type": "category"
  },
  "yAxis": {
    "max": 1,
    "min": 0,
    "type": "value"
  }
}交互式图表需要 JavaScript。您仍可查看或下载其 JSON 源代码。
查看源代码
{
  "legend": {
    "width": "80%"
  },
  "series": [
    {
      "data": [
        0.0181818,
        0.0363636,
        0.0545455,
        0.0727273,
        0.0909091,
        0.109091,
        0.127273,
        0.145455,
        0.163636,
        0.181818
      ],
      "name": "m=1",
      "type": "line"
    },
    {
      "data": [
        0.0387314,
        0.0767641,
        0.114058,
        0.150568,
        0.18625,
        0.221051,
        0.254916,
        0.287787,
        0.319597,
        0.350277
      ],
      "name": "m=2",
      "type": "line"
    },
    {
      "data": [
        0.0623607,
        0.122317,
        0.17976,
        0.234582,
        0.286682,
        0.335965,
        0.382357,
        0.425805,
        0.466296,
        0.503875
      ],
      "name": "m=3",
      "type": "line"
    },
    {
      "data": [
        0.0901537,
        0.174687,
        0.253418,
        0.326208,
        0.392976,
        0.453728,
        0.508577,
        0.55777,
        0.601688,
        0.640794
      ],
      "name": "m=4",
      "type": "line"
    },
    {
      "data": [
        0.123873,
        0.236513,
        0.337709,
        0.427439,
        0.505932,
        0.573733,
        0.631737,
        0.681121,
        0.723108,
        0.758835
      ],
      "name": "m=5",
      "type": "line"
    },
    {
      "data": [
        0.166654,
        0.312339,
        0.436946,
        0.541013,
        0.625933,
        0.694068,
        0.748498,
        0.792059,
        0.827084,
        0.855406
      ],
      "name": "m=6",
      "type": "line"
    },
    {
      "data": [
        0.224802,
        0.410906,
        0.558505,
        0.670021,
        0.750968,
        0.809768,
        0.852948,
        0.885072,
        0.909277,
        0.927732
      ],
      "name": "m=7",
      "type": "line"
    },
    {
      "data": [
        0.313537,
        0.551687,
        0.714389,
        0.811455,
        0.871435,
        0.909967,
        0.935546,
        0.952993,
        0.965166,
        0.973825
      ],
      "name": "m=8",
      "type": "line"
    },
    {
      "data": [
        0.481584,
        0.784844,
        0.89107,
        0.938902,
        0.963394,
        0.977002,
        0.985015,
        0.989947,
        0.99309,
        0.995152
      ],
      "name": "m=9",
      "type": "line"
    },
    {
      "data": [
        1,
        1,
        1,
        1,
        1,
        1,
        1,
        1,
        1,
        1
      ],
      "name": "m=10",
      "type": "line"
    }
  ],
  "title": {
    "text": "等差分布权重随机选取"
  },
  "tooltip": {
    "trigger": "axis"
  },
  "xAxis": {
    "boundaryGap": false,
    "data": [
      "i=1",
      "i=2",
      "i=3",
      "i=4",
      "i=5",
      "i=6",
      "i=7",
      "i=8",
      "i=9",
      "i=10"
    ],
    "type": "category"
  },
  "yAxis": {
    "max": 1,
    "min": 0,
    "type": "value"
  }
}交互式图表需要 JavaScript。您仍可查看或下载其 JSON 源代码。
查看源代码
{
  "legend": {
    "width": "80%"
  },
  "series": [
    {
      "data": [
        0.000977517,
        0.00195503,
        0.00391007,
        0.00782014,
        0.0156403,
        0.0312805,
        0.0625611,
        0.125122,
        0.250244,
        0.500489
      ],
      "name": "m=1",
      "type": "line"
    },
    {
      "data": [
        0.0025488,
        0.00509568,
        0.0101837,
        0.0203364,
        0.0405476,
        0.0805822,
        0.159009,
        0.308474,
        0.569214,
        0.804008
      ],
      "name": "m=2",
      "type": "line"
    },
    {
      "data": [
        0.00537735,
        0.0107444,
        0.0214475,
        0.0427281,
        0.0847763,
        0.166729,
        0.321243,
        0.584598,
        0.817744,
        0.944612
      ],
      "name": "m=3",
      "type": "line"
    },
    {
      "data": [
        0.0108642,
        0.021685,
        0.0431948,
        0.0856766,
        0.1684,
        0.324092,
        0.588553,
        0.82115,
        0.946757,
        0.989628
      ],
      "name": "m=4",
      "type": "line"
    },
    {
      "data": [
        0.021834,
        0.0434907,
        0.0862602,
        0.169534,
        0.326218,
        0.592157,
        0.823804,
        0.947919,
        0.989983,
        0.9988
      ],
      "name": "m=5",
      "type": "line"
    },
    {
      "data": [
        0.0440274,
        0.0873236,
        0.171618,
        0.330194,
        0.599069,
        0.828695,
        0.949851,
        0.990437,
        0.998866,
        0.999919
      ],
      "name": "m=6",
      "type": "line"
    },
    {
      "data": [
        0.0895401,
        0.175965,
        0.338491,
        0.613516,
        0.838615,
        0.953664,
        0.991303,
        0.998981,
        0.999928,
        0.999997
      ],
      "name": "m=7",
      "type": "line"
    },
    {
      "data": [
        0.18552,
        0.356749,
        0.645339,
        0.859134,
        0.961175,
        0.992947,
        0.999194,
        0.999944,
        0.999998,
        1
      ],
      "name": "m=8",
      "type": "line"
    },
    {
      "data": [
        0.401858,
        0.724258,
        0.902929,
        0.975573,
        0.995862,
        0.999551,
        0.99997,
        0.999999,
        1,
        1
      ],
      "name": "m=9",
      "type": "line"
    },
    {
      "data": [
        1,
        1,
        1,
        1,
        1,
        1,
        1,
        1,
        1,
        1
      ],
      "name": "m=10",
      "type": "line"
    }
  ],
  "title": {
    "text": "等比分布权重随机选取"
  },
  "tooltip": {
    "trigger": "axis"
  },
  "xAxis": {
    "boundaryGap": false,
    "data": [
      "i=1",
      "i=2",
      "i=3",
      "i=4",
      "i=5",
      "i=6",
      "i=7",
      "i=8",
      "i=9",
      "i=10"
    ],
    "type": "category"
  },
  "yAxis": {
    "max": 1,
    "min": 0,
    "type": "value"
  }
}交互式图表需要 JavaScript。您仍可查看或下载其 JSON 源代码。
Mathematica 提供了 RandomSample 函数,支持带权选取,当然它是在遍历之前就已经知道元素个数的。给它一组等差分布的权重,可以看出十万次随机选取后得到的概率分布与上面的理论分布非常接近。
count = 10;
weights = Range[count];
elems = Range[count];
retry = 100000;
map = Table[
    freq = ConstantArray[0, count];
    For [i = 0, i < retry, i++,
        freq += BinCounts[RandomSample[weights -> elems, m], {1, count + 1, 1}]
    ];
    freq, {m, 1, count, 1}
];
ListLinePlot[map / retry, PlotMarkers -> Automatic]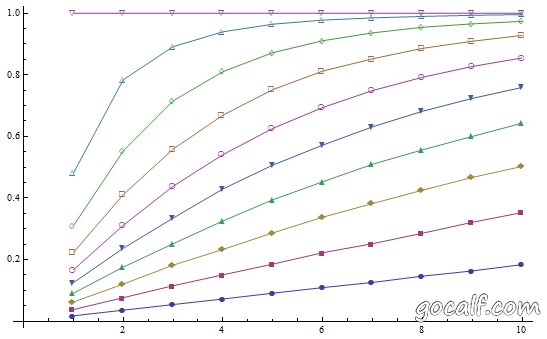
苦苦思考了好几天,但并没有想到一个直观的方法可以给之前的 RandomSample 加上权重处理。因为那概率式子太复杂,实在不知道该怎么去凑。不过在下一篇文章中将会介绍一个神奇的算法(当然不是我想出来的),并且会给出我的证明。
现在发文章的速度越来越慢了,实在因为能力有限,每次为了一两个式子都要演算很久。再接再厉。
评论需要 JavaScript。